Kubernetes Pod Deployment Service 入門|Docker 與 K8s 筆記 Ep-6
本篇重點
Ep-5 結尾預告要進 Kubernetes,這篇正式開始,先講 K8s 到底是什麼、解決 docker run 管不過來的哪些問題,再用 Pod、Deployment、Service 三個核心物件實測。會建一個裸 Pod,故意砍掉它讓你看它不會自動回來,再用 Deployment 包一層看差異。最後接上 Ep-5 寫的 HEALTHCHECK 觀念,示範 readinessProbe 失敗時 Pod 明明是 Running 卻打不通的真實情況。所有指令輸出都是本機實測,不是示意值。
Kubernetes 是什麼:docker run 管不過來的地方
Ep-1 到 Ep-5 做的事,說到底都是在一台機器上手動下指令:docker run、docker compose up,最多用 depends_on 控制兩三個容器的啟動順序。服務只有一兩個、只跑在一台機器上,這樣做完全沒問題。
但實際上線的服務通常不是這麼單純:可能要跑好幾個服務、分散在好幾台機器上分攤流量;某個容器半夜掛了,總不能等你早上上班才發現;流量變大時要多開幾個副本分流;換版本時如果全部容器同時砍掉重開,服務就會中斷。這些事光靠手動 docker run 管不過來,得有人(或有個系統)一直盯著。
Kubernetes(常縮寫成 K8s,因為 K 和 s 之間剛好夾了 8 個字母)就是做這件事的系統。它跑在一群機器(叫做節點,node)組成的叢集(cluster)上,你只要用 YAML 宣告「我要這個服務一直維持 3 個副本、對外開 80 port」,K8s 就會自己找機器把容器排上去、副本數量不夠自動補、流量自動分散到多個副本、換版本時一批一批汰換不會整批同時斷線。
換個角度理解:Docker 負責把一個應用程式連同它的執行環境包成一個可以到處複製的容器,這件事本身跟「要開幾個、開在哪台機器、掛了要不要重開」完全無關,那些是 K8s 在管的事。K8s 不會取代 Docker 去 build image,它是疊在容器執行環境上面的一層,專門處理「一大群容器要怎麼被穩定地跑起來」。
這篇會用三個核心物件,實際示範 K8s 具體是怎麼做到「掛了自動補」「流量自動分散」的:
- Pod:K8s 裡最小的部署單位,一個 Pod 可以跑一個或多個容器
- Deployment:管理 Pod 的物件,Pod 掛了它會自動補一個新的
- Service:Pod 的 IP 每次重建都會換,Service 提供一個不會變的連線入口
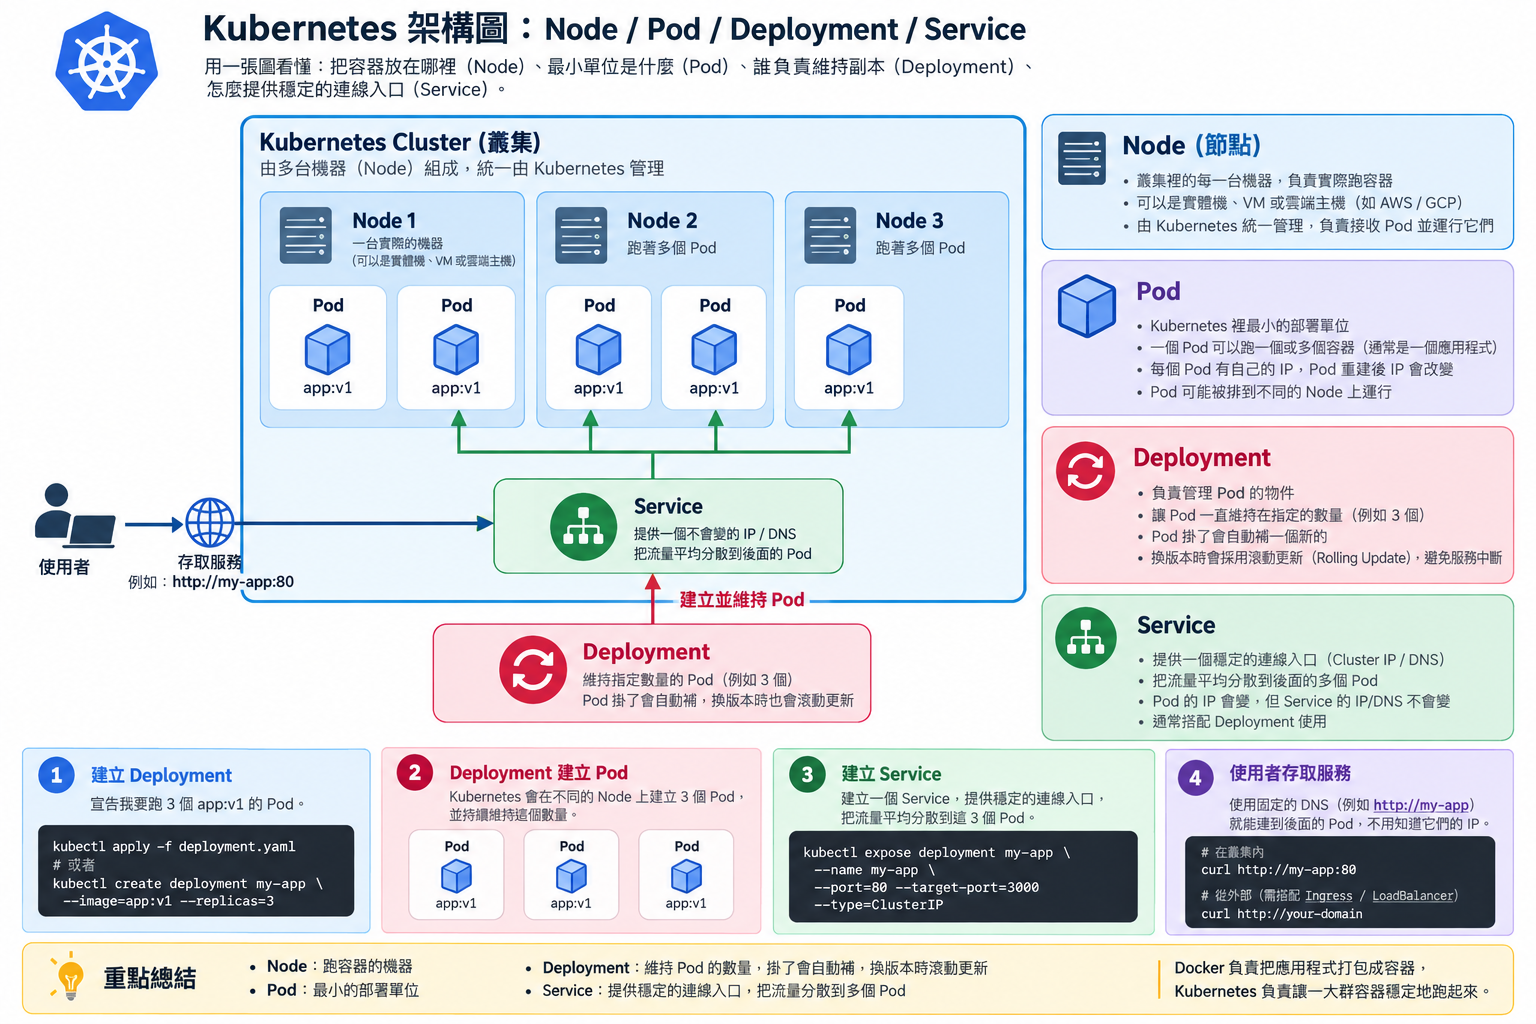
1. 先把環境準備好:安裝 kubectl 與啟用本機 Kubernetes
跑 K8s 指令要先裝 kubectl(K8s 的命令列工具),macOS 用 Homebrew 裝:
brew install kubectl裝完確認版本:
kubectl version --clientClient Version: v1.33.9
Kustomize Version: v5.6.0再來需要一個本機的 K8s 叢集(cluster,管理一群容器的集合)給 kubectl 連。如果你是照 Ep-1 裝的 Docker Desktop,設定裡 Settings → Kubernetes → Enable Kubernetes 打勾就會自動生出一個單節點叢集。我自己後來換成 OrbStack(Docker Desktop 的輕量替代品,內建 Kubernetes,不用額外裝 minikube 或 kind),這篇接下來的指令輸出都是用 OrbStack 跑的,開法是 App 內 Settings → Kubernetes 打勾,或用指令:
orbctl config set k8s.enable true
orbctl stop
orbctl start
設定改完 OrbStack 會提示 Restart OrbStack with "orbctl stop" to apply changes.,要整個停掉再開才會生效。注意 orbctl restart 是重啟 OrbStack 裡的 Linux machine,不是重啟 OrbStack 本身,用它不會套用這個設定。另外 orbctl stop 會把正在跑的 Docker 容器一起停掉,有開著的服務要先處理。
不管用哪一種,開完用 kubectl get nodes 確認能連到叢集:
kubectl get nodesNAME STATUS ROLES AGE VERSION
orbstack Ready control-plane 48d v1.35.6+orb1(AGE 顯示 48d 是因為我這台機器的叢集之前就開過,你第一次啟用會從幾秒開始算,不影響後面的操作。)
看到 STATUS 是 Ready 就代表叢集活著,可以開始丟東西進去了。
2. 光有 Pod 不夠:裸 Pod 被砍掉不會自動回來
Pod 是 K8s 裡最小的部署單位。這篇沿用 Ep-5 build 好的 my-node-app(帶 HEALTHCHECK 的 multi-stage image),寫一個最簡單的 Pod 設定檔:
# pod.yaml
apiVersion: v1
kind: Pod
metadata:
  name: my-node-app
spec:
  containers:
    - name: my-node-app
      image: my-node-app:latest
      imagePullPolicy: Never
      ports:
        - containerPort: 3000
imagePullPolicy: Never 是因為這個 image 是本機 build 的,沒推上任何 registry,告訴 K8s 不要嘗試去外部拉,直接用本機現有的。
kubectl apply -f pod.yaml
kubectl get pod my-node-app
pod/my-node-app created
NAME READY STATUS RESTARTS AGE
my-node-app 1/1 Running 0 5s現在故意把它砍掉,模擬 Pod 被誤刪,或是它所在的節點整台掛掉:
kubectl delete pod my-node-app --grace-period=0 --force
kubectl get pod my-node-app
Warning: Immediate deletion does not wait for confirmation that the running resource has been terminated. The resource may continue to run on the cluster indefinitely.
pod "my-node-app" force deleted
Error from server (NotFound): pods "my-node-app" not found--force 會印一行警告,意思是「不等確認容器真的停掉就直接把 Pod 從 API 移除」,這裡只是示範用。砍掉就真的沒了,K8s 不會自動生一個新的回來。
這裡要分清楚兩種「掛掉」。如果只是 Pod 裡的容器當掉(例如程式 crash),裸 Pod 其實會自己重啟容器:Pod 的 restartPolicy 預設是 Always,節點上的 kubelet 會把容器重新拉起來,RESTARTS 欄位的數字會往上加,效果類似 docker run --restart=always。裸 Pod 做不到的是 Pod 本身不見了 之後的重建:被刪除、被驅逐(evict,例如節點資源不足時被踢掉),或是所在節點整台掛掉,這時候沒有任何東西會幫你生一個新的 Pod。實務上沒有人會直接部署裸 Pod,這正是 Deployment 存在的原因。
3. Deployment:讓 Pod 掛了自動補回來
Deployment 是包在 Pod 外面的管理層,宣告「我要幾個這個 Pod 的副本一直存在」,K8s 會自己盯著數量,少了就補:
# deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-node-app
spec:
  replicas: 2
  selector:
    matchLabels:
      app: my-node-app
  template:
    metadata:
      labels:
        app: my-node-app
    spec:
      containers:
        - name: my-node-app
          image: my-node-app:latest
          imagePullPolicy: Never
          ports:
            - containerPort: 3000
kubectl apply -f deployment.yaml
kubectl get pods -l app=my-node-app -o widedeployment.apps/my-node-app created
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
my-node-app-6b6cc75d9b-v8hhf 1/1 Running 0 6s 192.168.194.103 orbstack <none> <none>
my-node-app-6b6cc75d9b-x942m 1/1 Running 0 6s 192.168.194.102 orbstack <none> <none>兩個副本都起來了,各自有獨立的 IP。現在砍掉其中一個,看 Deployment 的反應:
kubectl delete pod my-node-app-6b6cc75d9b-v8hhf
kubectl get pods -l app=my-node-app -o wide
pod "my-node-app-6b6cc75d9b-v8hhf" deleted
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
my-node-app-6b6cc75d9b-w5j4t 1/1 Running 0 31s 192.168.194.104 orbstack <none> <none>
my-node-app-6b6cc75d9b-x942m 1/1 Running 0 41s 192.168.194.102 orbstack <none> <none>v8hhf 消失了,多出一個 w5j4t,數量還是維持 2 個。注意這個新 Pod 的 IP 是 192.168.194.104,跟被砍掉那個的 192.168.194.103 不一樣,另一個沒被動到的 x942m 則維持原本的 192.168.194.102。
你跑的時候會發現 kubectl delete 卡了大約 30 秒才回來,而新 Pod 的 AGE 已經是 31s。原因是刪除 Pod 時 K8s 會先送 SIGTERM 讓程式自己收尾,預設最多等 30 秒(terminationGracePeriodSeconds),index.js 沒處理 SIGTERM,所以只能等到時間到被強制結束。但 Deployment 在 Pod 一進入刪除流程時就開始補新的,不用等舊的完全消失。這就是下一節要處理的問題:Pod 的 IP 完全不可靠,每次重建都可能換掉。
4. Service:Pod IP 一直換,靠什麼保持連得到
如果你的前端服務要連到 my-node-app,寫死 IP 192.168.194.103 過沒多久就會失效,因為 Pod 隨時可能因為重啟、擴縮容而換一個新的。Service 解決的就是這個問題:給一組 Pod 一個固定不變的入口,實際流量會被轉發到當下還活著的 Pod 上。
# service.yaml
apiVersion: v1
kind: Service
metadata:
  name: my-node-app
spec:
  selector:
    app: my-node-app
  ports:
    - port: 80
      targetPort: 3000
selector 用 label(app: my-node-app)去找要轉發給哪些 Pod,不管背後的 Pod 怎麼換,只要 label 對得上就會被納入。
kubectl apply -f service.yaml
kubectl get svc my-node-app
service/my-node-app created
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
my-node-app ClusterIP 192.168.194.240 <none> 80/TCP 3sClusterIP 類型的 Service 一般只能在叢集內部連到,不過 OrbStack 有個方便的地方:它讓 Mac 本機可以直接連到叢集裡的 Service IP 和 Pod IP,所以可以直接 curl 上面那個 CLUSTER-IP:
curl -s http://192.168.194.240/
curl -s -o /dev/null -w '%{http_code}\n' http://192.168.194.240/health
Hello, Docker!
200如果你用的是 Docker Desktop,本機連不到 ClusterIP,可以在叢集裡開一個暫時的 Pod 來打:kubectl run tmp --rm -it --image=curlimages/curl --restart=Never -- curl -s http://my-node-app/。
現在來驗證 Service 的重點:背後的 Pod 被砍掉時,這個入口會不會斷。開一個迴圈每 0.5 秒打一次、總共打 80 次,同時砍掉其中一個 Pod:
# 視窗 A:持續打 Service,最後統計各種回應碼出現幾次
for i in $(seq 1 80); do
  curl -s --max-time 2 -o /dev/null -w '%{http_code}\n' http://192.168.194.240/
  sleep 0.5
done | sort | uniq -c

# 視窗 B:迴圈跑起來之後砍掉一個 Pod
kubectl delete pod my-node-app-6b6cc75d9b-w5j4t --wait=false
kubectl get pods -l app=my-node-app -o wide
視窗 B 砍完 5 秒後的狀態:
pod "my-node-app-6b6cc75d9b-w5j4t" deleted
NAME                           READY   STATUS        RESTARTS   AGE   IP                NODE       NOMINATED NODE   READINESS GATES
my-node-app-6b6cc75d9b-lhxhm   1/1     Running       0          5s    192.168.194.105   orbstack   <none>           <none>
my-node-app-6b6cc75d9b-w5j4t   1/1     Terminating   0          60s   192.168.194.104   orbstack   <none>           <none>
my-node-app-6b6cc75d9b-x942m   1/1     Running       0          70s   192.168.194.102   orbstack   <none>           <none>
視窗 A 跑完的統計:
80 20080 次全部是 200。Pod 在背後被砍掉又重建(192.168.194.104 換成 192.168.194.105),但 192.168.194.240 這個入口全程沒斷過。這就是 Service 的價值:呼叫端永遠只認一個固定位址,背後 Pod 怎麼生怎麼死都不用管。
這裡刻意不用 kubectl port-forward svc/my-node-app 來測。port-forward 雖然寫的是 Service,實際上它在啟動那一刻挑一個 Pod 就一直直連那個 Pod,流量根本沒經過 Service。我實測用 kubectl rollout restart 把 Pod 全部換掉之後,port-forward 直接斷線:
error: lost connection to pod所以用 port-forward 測「Service 會不會斷」是測不出來的,它斷不斷只取決於你剛好砍到哪一個 Pod。
5. livenessProbe 與 readinessProbe:Running 不等於能用
Ep-5 最後提過 Docker 的 HEALTHCHECK 跟 K8s 的 probe 是同一套觀念,這裡把它接上。要先講清楚:K8s 完全不會讀 image 裡的 HEALTHCHECK,就算 Dockerfile 寫了,K8s 也不會拿來用,probe 一定要在 YAML 裡另外寫。STATUS 顯示 Running 只代表容器行程還活著,不代表應用程式真的能服務,K8s 用兩種探測分別處理兩件事:
- readinessProbe:判斷 Pod 現在能不能收流量,沒過的話 Service 會直接把它排除在轉發名單外
- livenessProbe:判斷容器是不是已經卡死了,沒過的話 K8s 會重啟這個容器
在 Deployment 加上兩個 probe,都打 Ep-5 加的 /health 路由:
# deployment-probes.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-node-app
spec:
  replicas: 2
  selector:
    matchLabels:
      app: my-node-app
  template:
    metadata:
      labels:
        app: my-node-app
    spec:
      containers:
        - name: my-node-app
          image: my-node-app:latest
          imagePullPolicy: Never
          ports:
            - containerPort: 3000
          readinessProbe:
            httpGet:
              path: /health
              port: 3000
            initialDelaySeconds: 2
            periodSeconds: 5
          livenessProbe:
            httpGet:
              path: /health
              port: 3000
            initialDelaySeconds: 5
            periodSeconds: 10
套用後查 Service 背後實際轉發的端點:
kubectl apply -f deployment-probes.yaml
kubectl get endpoints my-node-app
Warning: v1 Endpoints is deprecated in v1.33+; use discovery.k8s.io/v1 EndpointSlice
NAME ENDPOINTS AGE
my-node-app 192.168.194.114:3000,192.168.194.115:3000 4m40s兩個 Pod 都通過 readinessProbe,端點列表跟兩個 Pod 的 IP 對得上。第一行的 Warning 是說 v1 Endpoints 這個 API 從 K8s 1.33 開始標記為棄用,官方要大家改用 EndpointSlice,但目前還能正常用。這裡刻意繼續用 get endpoints,因為它的 ENDPOINTS 欄位只列「已經 ready、真的會收到流量」的 Pod,最適合拿來看 readinessProbe 的效果;kubectl get endpointslices 的 ENDPOINTS 欄位則會把沒 ready 的 Pod 也一起列出來(只是在內部標記成 not ready),等一下壞版本出現時會看起來像被納入了,反而容易誤會。現在故意把 readinessProbe 的路徑改錯(模擬部署了一個健康檢查路由寫錯或改名的壞版本),只改 readinessProbe,livenessProbe 保持正確:
# deployment-probes-broken.yaml(只有 readinessProbe 的 path 改掉)
          readinessProbe:
            httpGet:
              path: /wrong-path
              port: 3000
kubectl apply -f deployment-probes-broken.yaml
kubectl get pods -l app=my-node-appNAME READY STATUS RESTARTS AGE
my-node-app-5c56fd899d-jhslj 1/1 Running 0 53s
my-node-app-5c56fd899d-pcf62 1/1 Running 0 50s
my-node-app-f8f47c7c7-hxz5w 0/1 Running 0 12s新版本的 Pod(f8f47c7c7-hxz5w)狀態是 Running,但 READY 顯示 0/1,就是「行程活著、但沒過健康檢查」的狀態。查它的事件看實際錯誤:
kubectl describe pod my-node-app-f8f47c7c7-hxz5wWarning Unhealthy 3s (x6 over 28s) kubelet Readiness probe failed: HTTP probe failed with statuscode: 404跟預期一致,/wrong-path 打回來是 404。再看 Service 的端點,這個沒過檢查的 Pod 完全沒被排進去:
kubectl get endpoints my-node-appWarning: v1 Endpoints is deprecated in v1.33+; use discovery.k8s.io/v1 EndpointSlice
NAME ENDPOINTS AGE
my-node-app 192.168.194.114:3000,192.168.194.115:3000 5m12s端點還是原本兩個舊 Pod 的 IP,新的壞版本被 Service 自動擋在外面,不會有任何流量打到它,這就是 readinessProbe 存在的意義。順帶一提,Deployment 的滾動更新(一次汰換一部分 Pod,不是全部一次砍掉重來)也被這個檢查卡住了:
kubectl rollout status deployment/my-node-app --timeout=5sWaiting for deployment "my-node-app" rollout to finish: 1 out of 2 new replicas have been updated...
error: timed out waiting for the condition新版本一直卡在「1 out of 2」,因為它過不了健康檢查,K8s 不會繼續把剩下的舊 Pod 也換成壞版本,等於幫你擋下一次全站炸掉的部署。發現問題後用 rollout undo 退回上一版:
kubectl rollout undo deployment/my-node-app
kubectl get pods -l app=my-node-app
deployment.apps/my-node-app rolled back
NAME READY STATUS RESTARTS AGE
my-node-app-5c56fd899d-jhslj 1/1 Running 0 77s
my-node-app-5c56fd899d-pcf62 1/1 Running 0 74s
my-node-app-f8f47c7c7-hxz5w 0/1 Terminating 0 36s壞版本的 Pod 被清掉,兩個正常的舊 Pod 繼續撐著服務,全程沒有斷過。
結論
這篇實測下來,Pod、Deployment、Service 三者的分工其實很清楚:
- Pod 是最小部署單位,裸 Pod 的容器 crash 時 kubelet 會重啟它,但 Pod 本身被刪除或節點掛掉就真的沒了
- Deployment 盯著 Pod 數量,少了自動補,這是 K8s「自我修復」說法的實際來源
- Pod 的 IP 每次重建都會換,Service 提供一個不會變的入口,呼叫端不用管背後 Pod 怎麼生怎麼死
- readinessProbe 決定 Pod 能不能收流量,livenessProbe 決定容器要不要被重啟,兩者都對應到 Ep-5 的 HEALTHCHECK 觀念,而且 readinessProbe 在滾動更新時能直接擋下一次全壞的部署
下一篇打算幫這個 my-node-app 接上 ConfigMap 和 Secret 管設定,處理「環境變數和密碼不該寫死在 image 裡」這件事。
延伸閱讀
- Kubernetes 官方文件:Pods
- Kubernetes 官方文件:Deployments
- Kubernetes 官方文件:Service
- Kubernetes 官方文件:Liveness、Readiness 與 Startup Probes
- OrbStack Kubernetes 文件
系列文章導覽
相關文章
Docker 是什麼?容器化技術入門|Docker 與 K8s 筆記 Ep-0
用生活化比喻解釋 Docker 是什麼、容器化技術解決哪些開發痛點,以及 Docker 和虛擬機的本質差別。完全沒碰過容器的新手也能快速看懂。
Docker & K8sDocker 安裝與基本指令教學|Docker 與 K8s 筆記 Ep-1
手把手從 Docker Desktop 安裝開始,帶你跑 docker pull、run、ps、stop、rm 等常用指令,跟著做就能在本機啟動你的第一個容器。
Docker & K8sDockerfile 教學:Image 與 Container 差別|Docker 與 K8s 筆記 Ep-2
釐清 Docker Image 和 Container 的本質差異,並實作一個 Node.js 應用的 Dockerfile,學會 FROM、COPY、RUN、CMD 四個核心指令。